从经验走向证据:基于AI大模型的课堂教学评价模型构建与应用实践
——以课程标准为纲、以测评学理论为基的系统性建构
全文约 1 万字 · 阅读约需 25 分钟
导读
为什么课堂评价需要AI大模型? 2022年版课程标准确立了核心素养导向与“教—学—评”一致性要求,课堂评价必须从“知识点对错”升级为“素养表现证据”的收集与解释;而传统听评课“凭感觉、难全景、弱反馈”,恰好卡住了这一升级。
本文提出什么? 以证据中心设计(ECD)与基于论证的效度理论为方法论,以LICC课堂观察框架与CLASS课堂评估系统为维度来源,构建“一个内核、四大支柱、五层架构、三元协同”的AI大模型课堂教学评价模型,并给出可落地的实施流程、指标框架、效度论证清单与学校“三步走”行动路线。
写给谁? 关心课堂教学改进的校长、教研员、一线教师,以及区域教育质量监测与教育数字化工作的实践者与研究者。
一节课究竟上得怎么样?一百年来,这个问题主要靠听评课者的经验直觉来回答。当AI大模型能够“看懂”课堂视频、“听懂”师生对话、“写好”分析报告时,课堂评价第一次有可能完整地做到:让证据说话,让教师判断,让学生被看见。
一、时代之问:课堂评价为什么要走向“人机协同”
(一)政策坐标:课程改革与教育数字化的“双轮驱动”
2022年4月,教育部印发《义务教育课程方案和课程标准(2022年版)》。新课程以核心素养为纲,要求各科课程标准不仅规定“教什么、学什么”,更以学业质量标准刻画“学到什么程度”,并明确提出注重实现“教—学—评”一致性[1][2]。这意味着课堂评价的对象发生了根本变化:从零散知识点的对错判断,升级为对素养表现证据的系统收集与专业解释;评价不再只是教学结束后的“验收”,而是嵌入教学全过程的“调节器”。
评价要求的升级,恰与传统评价手段的能力瓶颈迎头相撞——这正是技术必须进场的原因。2025年1月,《教育强国建设规划纲要(2024—2035年)》发布,明确提出实施教育数字化战略、促进人工智能助力教育变革[3]。2025年5月,教育部基础教育教学指导委员会发布《中小学人工智能通识教育指南(2025年版)》与《中小学生成式人工智能使用指南(2025年版)》,将“辅助教师教学”“支撑教育管理”明确列为生成式人工智能的核心应用场景,同时要求建立工具“白名单”制度、严禁输入考试试题与个人身份信息等敏感数据[4][5]。同年,教育部办公厅印发《关于组织实施数字化赋能教师发展行动的通知》(教师厅函〔2025〕13号),推动人工智能技术支持教师课堂教学诊断与专业发展[6]。
一句话概括政策逻辑:课程标准决定了课堂评价“必须升级”,教育数字化战略则为课堂评价“如何升级”提供了技术通道与制度边界。
(二)现实痛点:传统课堂评价的“三低三难”
课堂是教育质量的生命线,也是信息最密集、变化最快的评价现场。但长期以来,我们对课堂的评价能力严重滞后于课堂本身的复杂度,可以概括为“三低三难”:
● 效率低。人工听评课一节课需要半天以上的准备与研讨,一位教研员一学期所能覆盖的课例极其有限;对绝大多数教师而言,一年也未必能获得一次高质量的深度评课。
● 维度低。经验式评课往往停留于“总体印象+局部点评”。沈毅、崔允漷在《课堂观察:走向专业的听评课》中将其概括为“三无”——无合作的任务、无证据的推论、无研究的实践[7]。评课结论常常是“这节课氛围不错”“节奏偏快”这类无法证伪也难以改进的判断。
● 反馈低。评完即止,评价结论没有转化为可追踪的教学改进行为,更谈不上基于证据的持续迭代。
● 难全景。一名观察者在一节课内能有效捕捉的信息极其有限:既要听教师讲什么,又要看学生学什么,还要记录时间线——LICC范式之所以要求多名观察者分工认领观察点,正因为“全能观察者”并不存在[7][8]。
● 难持续。课堂评价多以“一课一评”的离散事件存在,缺少跨课次、跨学期的纵向数据,无法刻画教师教学能力与学生学习状态的发展轨迹。
● 难一致。不同评课人对同一节课的判断常常大相径庭,印象化、人情化因素难以避免,评价结论的信度与公平性备受质疑。
(三)技术拐点与国际趋势:能力已经到位,理论尚未跟上
近年来,AI大模型在课堂场景所需的三种核心能力上实现了跃迁:一是多模态感知——语音转写在教学场景实用条件下的准确率已普遍超过95%,主流目标检测模型(如YOLOv8)在标准数据集上的平均精度(mAP)已达85%左右,师生行为、板书课件等课堂视觉要素可被稳定识别;二是语义理解与推理——大模型能够理解对话的认知层次、提问的思维含量,而不再停留在“举手次数”式的行为统计;三是自然语言生成——评价结果可以自动组织为面向教师的专业报告,而不是一堆教师看不懂的指标。国外已有研究团队尝试利用GPT-4V等视觉大模型对课堂教学视频进行自动评估,初步验证了“视频进、专业评价报告出”的技术可行性。
国际调查同样印证了这一趋势,但也揭示了一个耐人寻味的“缺口”。OECD教师教学国际调查(TALIS 2024)覆盖55个教育体系,首次系统调查了教师的AI使用情况:OECD平均约36%的初中教师在过去一年使用过AI,新加坡达75%,我国上海为53.5%,显著高于平均值[9][10]。但在使用AI的教师中,用于“高效学习与总结主题”的占68%、用于“生成教案”的占64%,而用于“复核学生参与或表现数据”的仅占25%,用于“评估或评分学生作业”的仅占26%[9]。
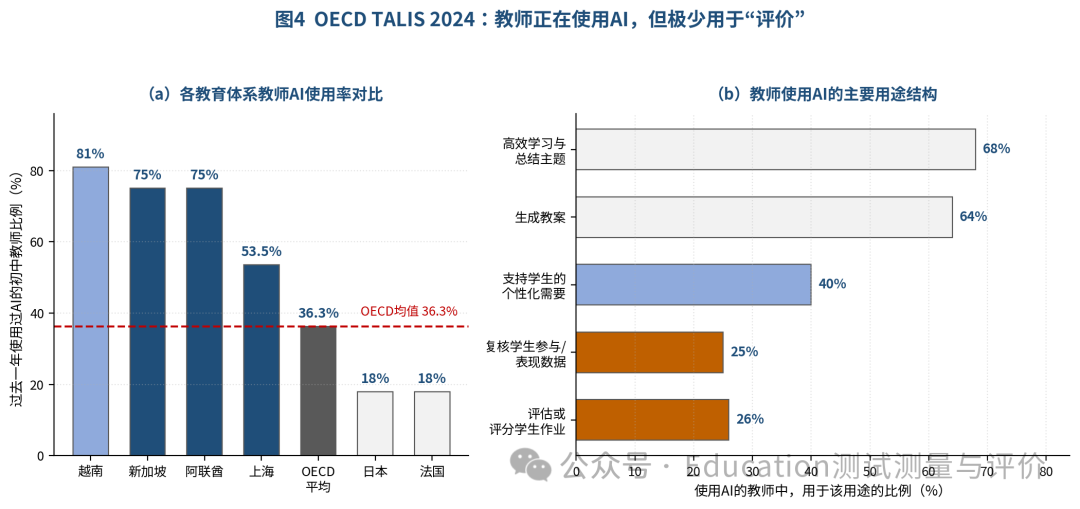
换言之,全球教师正在热烈地把AI用于备课与资源生成,却很少把它用在最专业、最敏感、也最有价值的环节——评价。这个缺口恰恰说明:AI进入课堂评价,缺的不是算力和模型,而是缺一套回答“评什么、凭什么评、评了能不能信”的专业理论框架。这正是本文要解决的问题。
比较维度 | 传统人工听评课 | AI大模型支持的课堂评价 |
证据采集 | 人工记录,容量有限,多依赖主观印象 | 多模态全程采集:视频、音频、文本、互动轨迹、作业数据 |
分析维度 | 以教师教学为主,学生视角不足 | 师、生、课程、文化多维并行,覆盖LICC四维度20视角 |
覆盖范围 | 抽样式、离散式(一课一评) | 伴随式、连续式,可跨课次纵向追踪 |
反馈时效 | 课后数天,结论笼统 | 课后即时生成报告,附时间戳与原始片段证据 |
一致性 | 因人而异,信度难保障 | 量规统一、标准一致,可做人机一致性检验 |
改进闭环 | 评完即止,难以追踪 | 证据沉淀为档案,支撑教研、培训与持续改进 |
表1 传统听评课与AI大模型支持的课堂评价之比较
二、理论基石:模型的三大理论支柱
任何教育评价模型都必须回答三个元问题:评什么(构念)——凭什么(证据)——为何可信(效度)。我们对这三个问题的回答,分别来自课程标准的素养导向、证据中心设计的证据逻辑,以及测评学的效度理论;而LICC课堂观察范式与CLASS课堂评估系统,则提供了维度体系的“家底”。
(一)支柱一:课程标准——核心素养导向与“教—学—评”一致性
课程标准为评价模型提供构念来源,即“评什么”的最终依据。义务教育课程方案(2022年版)以核心素养统领课程目标、课程内容与学业质量,明确要求“注重实现‘教—学—评’一致性”[1][2]。华东师范大学崔允漷教授团队对这一命题有系统阐释:教师的教、学生的学、对学习的评,三者应当指向同一目标、彼此咬合——评价不是教学的终点检查,而是贯穿始终的调节机制[8]。
落实到课堂,“教—学—评”一致性呈现为大小两个闭环(图1):课程层大闭环保证“方向一致”——素养目标经学业质量标准分解为课堂目标,课堂教学评价所收集的证据最终回证素养达成;课堂层小闭环保证“过程一致”——目标导学、任务驱动、即时评价、反馈调整在课内快速循环。AI大模型的价值,正在于让这两个闭环第一次拥有了全程、精细、可追溯的证据流:大闭环需要“课堂证据回证素养达成”,AI提供跨课次聚合的纵向证据;小闭环需要“即时评价、即时反馈”,AI提供课中实时的过程性证据。
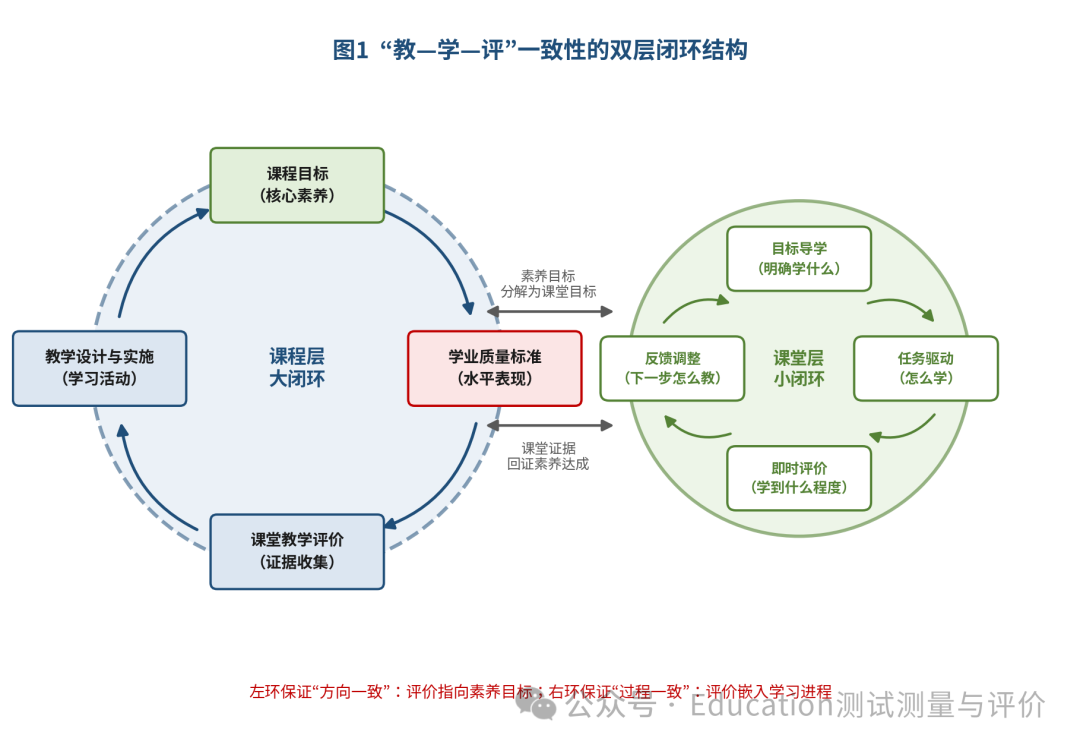
由此,模型的第一个设计原则确立:评价指标必须能沿“素养目标→学业质量水平→课堂可观察行为”的路径向下追溯。评价什么,不由技术决定,而由课程标准决定;技术解决的是“证据从哪里来、如何聚合”,而不是“标准是什么”。
(二)支柱二:测评学效度理论——让“机器评分”可辩护
把课堂评价交给算法,最尖锐的质疑是:机器给出的等级,凭什么可信?测评学(educational measurement)对此有百年积累的理论回答。
Messick在经典论文中提出效度的统一观:效度是对测验分数之解释与使用是否合理、是否恰当的综合性质评价,且必须将测试后果纳入考量[12]。Cronbach与Meehl早在1955年就指出,当评价指向“核心素养”这类无法直接观察的构念(construct)时,必须通过构念的网络化证据来为推论辩护[14]。Kane进一步发展出基于论证的效度检验框架:先构建“解释论证”——从观察到概括、从概括到外推、从外推到决策的完整推理链;再逐环节检验其合理性假设,形成效度论证[13]。美国《教育与心理测试标准》(AERA/APA/NCME, 2014)将效度证据归纳为五个来源:基于内容、基于反应过程、基于内部结构、与其他变量间的关系、基于测试后果[16]。
这套理论对AI课堂评价不是“学院派的装饰”,而是直接的工程图纸:表2给出了五类效度证据在AI课堂评价中的操作化落实要点。可以说,一个AI评价模型如果没有效度论证,就只是一个“自动打分器”;有了效度论证,它才是一件“评价仪器”。
效度证据来源 | 核心问题 | AI课堂评价的操作化落实 |
基于内容 | 指标体系是否代表评价构念的实质内容? | 建立“指标—课标/学业质量—观察点”映射表;经学科专家与教研组两轮审议 |
基于反应过程 | AI识别与理解是否准确可靠? | 行为识别与语义判断抽样复核,报告混淆矩阵;人机一致性抽检不低于20%课例 |
基于内部结构 | 指标间关系是否符合理论预期? | 检验指标相关结构与因子结构,如“对话质量”应与“思维参与”而非“纪律控制”强相关 |
与其他变量的关系 | 评价结果是否与外部效标关联? | 与专家评课结论、学生学业进步数据、教师专业发展指标做关联与追踪研究 |
基于测试后果 | 评价是否真正改进了教学?有无负面效应? | 监测教学改进行动率、教师满意度、申诉率;坚持发展性取向,不用于教师排名与惩罚 |
表2 五类效度证据在AI课堂评价中的操作化落实(据AERA/APA/NCME, 2014[16])
(三)支柱三:证据中心设计——把评价当作“证据推理”来设计
如果说效度理论回答“为何可信”,那么Mislevy、Steinberg与Almond提出的证据中心设计(Evidence-Centered Design,ECD)则回答“如何构造”[15]。ECD把一切测评看作关于学生能力的证据推理过程,要求设计者先回答三个问题,并对应建立三个模型:学生模型——评什么构念及其层级;证据模型——哪些可观察表现构成证据、如何按规则计分;任务模型——在什么情境中引出这些表现。迁移到课堂评价:学生模型即“素养+课堂评价指标体系”;证据模型即“可观察行为→指标得分”的计分规则;任务模型就是真实课堂活动本身——这是课堂评价区别于纸笔测验的独特之处,也是AI多模态感知能够发挥优势之处。
在证据的组织方式上,图尔敏(Toulmin)的论证结构——主张、资料、正当理由、支援、备择解释——为AI评价的每一条结论提供了“证据链模板”[18]。下面以一个真实形态的评价结论为例:
【主张】本节课“学生高阶参与”水平较高(4/5级)。【资料】系统识别到本课出现7轮高质量师生对话,其中5轮含追问与证据引用;学生主动提问23次,分布覆盖12个学习小组中的11个。【正当理由】课程标准关于思维品质的素养要求;课堂研究关于“对话质量—思维参与”的稳定证据。【支援】CLASS“教学支持”领域的计分研究;LICC“学生学习·互动”视角的观察点界定[7][17]。【备择解释】话题本身易引发讨论?教师提问偏易?——系统调取问题认知层次分布(本课分析评价类占41%)与候答时间等对照指标,予以排除。
这张“论证单”同时就是人机分工的设计图:机器负责“资料”的海量采集与初步归纳;“正当理由”与“支援”由课程标准、量规与学科知识库事前注入;对“主张”成立与否的最终裁定、对备择解释的教育学权衡,由教师完成。
(四)专业积淀:LICC范式与CLASS系统的“可计算化改造”
维度体系不能凭空发明。本土方面,沈毅、崔允漷团队提出的LICC课堂观察范式将课堂解构为学生学习(L)、教师教学(I)、课程性质(C)、课堂文化(C)四个维度、20个视角、68个观察点,并形成“课前会议—课中观察—课后会议”的专业流程[7]。尤为重要的是,崔允漷指出课堂观察工具包含三要素——主题构念、数据变量/维度、具体数据/行为[8],这恰好给出了一条“可计算化”路线图:把构念分解为变量、把变量锚定为行为,正是机器可学习、可判定的前提。国际方面,Pianta等人开发的CLASS课堂评估系统以情感支持、班级组织、教学支持三大领域、7点行为锚定量表刻画课堂质量[17],其“行为锚定等级”的量表形态天然适配大模型的等级判定任务。
表3展示了将两者融合并“AI化改造”后的维度体系节选(完整版由学校结合学科实际开发)。改造遵循三条原则:可追溯(每个指标能溯源到课标要求或权威量表)、可计算(每个指标有明确的数据变量与行为锚点)、可解释(每个等级判定附证据引用与时间戳)。
维度 | 视角 | 观察点示例 | AI可计算指标(节选) |
学生学习 | 达成 | 学生清楚学习目标;有目标达成的证据 | 目标—活动一致率;当堂达成度(练习正确率、板演与作品质量) |
学生学习 | 互动 | 提问与对话的深度;小组协作质量 | 问题认知层次分布;追问率;候答时间;发言覆盖面与分布均衡度 |
教师教学 | 对话 | 高质量问题链;对学生应答的利用 | IRF互动结构分析;生成性回应率;重述与转问频次 |
教师教学 | 指导 | 反馈的针对性、层次性与激励性 | 反馈类型分布(简单表扬/具体指导/启发追问);差异化指导覆盖率 |
课程性质 | 目标 | 目标明确、贯穿并回扣 | 目标呈现与回扣次数;目标—任务—评价一致率 |
课程性质 | 评价 | 课堂评价嵌入教学过程 | 即时评价发生密度;评价后的教学调整行为(改错、重讲、变式) |
课堂文化 | 民主 | 课堂氛围公平、安全、鼓励表达 | 师生言语时长比;正向反馈率;低成就学生被关注频次 |
表3 AI课堂评价维度体系(示例节选,融合LICC[7]与CLASS[17]并作可计算化改造)
三、模型构建:一个内核、四大支柱、五层架构、三元协同
(一)总体架构
综合上述理论基础,我们提出基于AI大模型的课堂教学评价模型(AICEM:AI-based Classroom Evaluation Model)。模型的内核是“证据素养”:一切评价活动围绕“收集证据—组织证据—解释证据—改进教学”展开。内核之外是四大支柱:课程标准定构念、测评学理论立效度、证据中心设计给方法、课堂观察范式供维度。技术上,模型表现为五层架构(图2);机制上,模型落实为“机器—教师—教研组”三元协同。
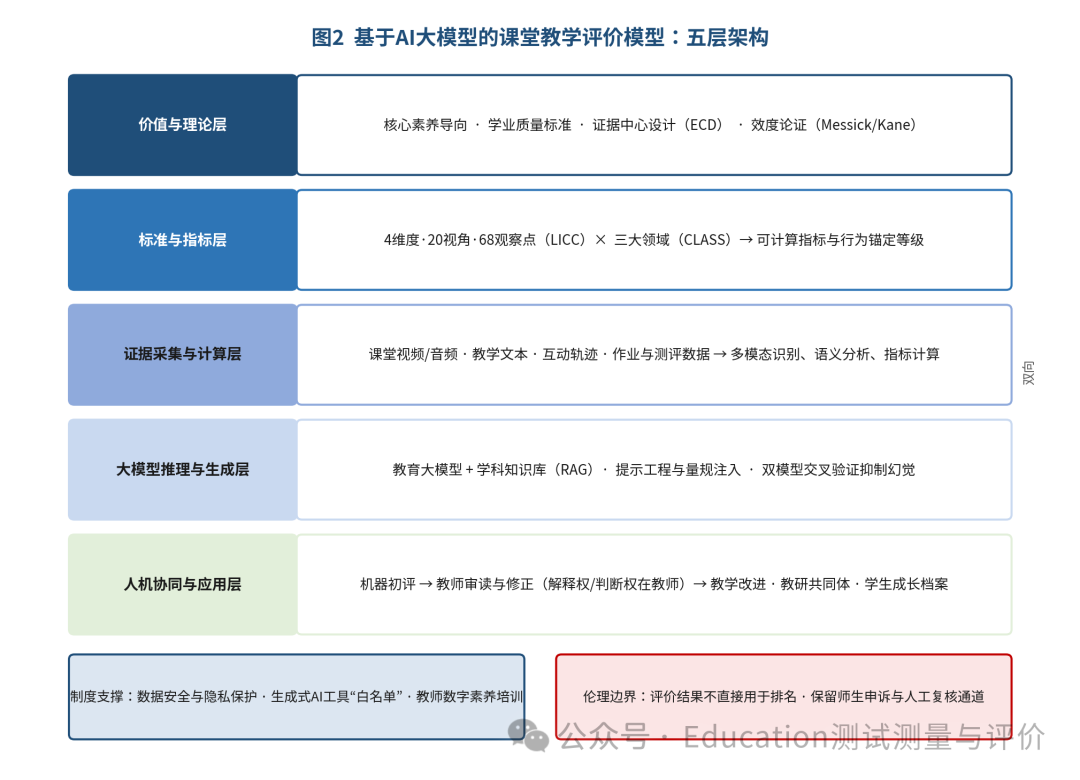
五层架构的要点如下:价值与理论层是顶层设计,防止技术空转——所有指标与算法都要回答“服务于什么素养目标、依据什么效度标准”;标准与指标层把LICC四维度与CLASS三大领域改造为可计算指标与行为锚定等级;证据采集与计算层负责多模态数据的结构化,形成课堂“数据底座”;大模型推理与生成层执行量规注入、检索增强生成(RAG)与双模型交叉验证,产出带证据引用的评价结论;人机协同与应用层保证解释权与判断权始终在教师,评价结果流向教学改进、教研共同体与学生成长档案。
(二)大模型推理链:让每一句评价都“带证据说话”
大模型直接“裸评”课堂,必然遭遇幻觉与随意性问题。模型的推理链设计为四步:
● 量规注入。评价前把行为锚定量规(含各级别的典型行为描述)写入提示词,要求模型逐条对照锚点判定,而非自由发挥。这对应崔允漷所说的观察工具三要素中“主题构念→数据变量→具体行为”的专业逻辑[8]。
● 检索增强(RAG)。挂载学科课程标准、教材单元、优秀课例库与校本教研案例,使模型的判断有“本学科、本校”的参照系。
● 双模型交叉验证。由通用大模型完成初评,再由强推理模型独立复核;两次结论不一致的条目自动标记为“待人工裁定”,从机制上抑制幻觉。
● 证据强制引用。每条评价结论必须附时间戳与原始证据片段(视频片段、对话原文),无证据的结论视为无效输出。
(三)人机协同流程:课前—课中—课后三阶段九环节
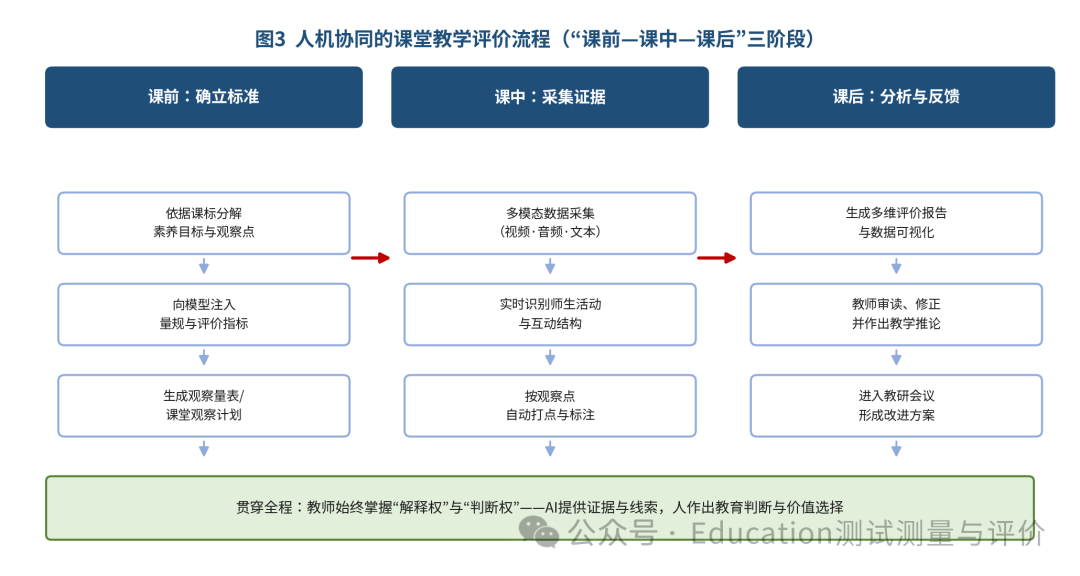
模型不是“机器评完人签字”,而是把AI嵌入听评课的完整专业流程(图3):课前确立标准——依据课标分解素养目标与观察点,向模型注入量规,生成观察量表与观察计划,对应LICC“课前会议”;课中采集证据——多模态数据采集与实时识别,按观察点自动打点标注,教师仍按分工进行关键行为的人工记录;课后分析与反馈——系统生成多维评价报告与可视化图表,教师审读、修正并作出教学推论,教研会议基于证据形成改进方案,对应“课后会议”。
主体 | 核心职责 | 不可替代性 |
AI系统 | 全程采集与识别;初步等级判定;报告生成;跨课次趋势分析 | 处理海量多模态数据的速度与一致性 |
授课教师 | 提供教学设计与反思;审读报告;确认或申诉结论;制定改进方案 | 对教学意图与课堂情境的解释权 |
评课教师与教研组 | 确定观察点;本地化修订指标;仲裁争议结论;沉淀校本案例;监测效度 | 教育价值判断与同伴互助的专业共同体验 |
表4 “机器—教师—教研组”三元协同的职责分工
(四)效度论证:让评价模型“持证上岗”
模型上线不是终点,而是效度论证的开始。建议以学年度为周期执行四步论证循环:第一步,明确分数解释主张——“该课‘教学支持’为4级”究竟意味着什么,须给出可检验的界定;第二步,列举推理链各环节的假设——识别准确吗?抽样能代表常态课吗?等级锚点在学科间等值吗?第三步,逐条收集表2所列五类证据,人机一致性、专家一致性、效标关联、后果监测逐年累积;第四步,形成年度效度报告,据以修订指标与量规、迭代模型。效度论证由学校与专业机构共同约定合格线(如与专家评分的一致性水平),达标前,AI结论一律定位为“证据线索”而非“评价结论”。
(五)实施保障:制度、数据与素养
● 制度保障。依据《中小学生成式人工智能使用指南(2025年版)》建立工具“白名单”制度,仅允许数据安全合规、经审核评估的工具进入课堂[5];明确评价结果的发展性用途,与绩效、排名脱钩。
● 数据安全。课堂音视频涉及未成年人肖像与语音,须坚持最小必要采集、本地化或专有云部署、匿名化处理,并在家长知情同意后开展;严禁向公开大模型输入试题、个人身份信息等敏感数据[4][5]。
● 教师数字素养。将“读懂AI报告、质疑AI结论、用证据研讨”纳入校本研修;这与教育部数字化赋能教师发展行动的方向一致[6]——教师不必成为算法专家,但必须成为AI评价结论的“专业审读人”。
四、应用实践:五类典型场景与推进策略
场景一:循证式课堂诊断——让教师第一次“全息地”看见自己的课
对教师个体而言,模型最直接的价值是把“自我认知的盲区”变成“有证据的改进点”。系统生成的课例报告包含三部分:课堂结构图(环节与时间分配)、多维指标雷达图(对照校准基线)、证据片段集(关键事件的时间戳与原文)。教师读报告只需追问三个“证据链”问题:结论引用了哪些片段?等级判定的行为锚点是什么?下一个同类课我要改哪一个行为?值得一提的是,经典的课堂量化分析方法——如弗兰德斯互动分析(FIAS)的言语互动分类、S-T分析法的教学行为曲线——均可由AI自动完成并高频化,从“学期做一次”变为“每课自动出”,老方法在新底座上重获生命力。
场景二:校本教研升级——LICC流程的“AI增强版”
在LICC“课前会议—课中观察—课后会议”框架内[7],AI承担“不知疲倦的观察员”:课前协助生成各观察者的个性化量表;课中同步打点,观察者聚焦于机器难以判定的意义与情感;课后会议则以“证据墙”取代“印象辩论”——所有观点必须挂接系统标注的证据片段。据公开报道,陕西师范大学实验小学研发的“AI教研员”已在区域内的三千余所学校推广使用,支撑常态化循证教研;这类实践提示:当证据成为教研的共同语言,评课就能从“权威裁决”走向“专业研讨”。
场景三:区域教学质量监测——给课堂做“体检”而不是“排名”
区域层面可采用“抽样录像+伴随式数据”的监测设计,形成区域课堂教学画像:各学科的问题认知层次结构、师生话语分布、目标达成证据链等。需要特别强调:区域应用的价值在于诊断与资源配置(哪些维度存在区域性短板、培训应聚焦什么主题),而非校际排名。模型的设计原则之一——评价结果不直接用于奖惩——在区域场景中尤须坚守。
场景四:学生课堂表现的过程性评价——让成长档案“有据可查”
学生的发言频次、合作行为、课堂任务表现等过程数据,可沉淀为综合素质评价的过程性证据,回应《通识教育指南》“完善评价实施机制,形成学生人工智能素养成长档案”的方向[4]。但须设置两道防线:其一,多主体校验——教师确认与学生互证并存,防止数据误判;其二,警惕“数据标签化”——发言少的课堂未必是参与少的课堂,安静而深度的学习同样珍贵,指标解读必须回到教师的专业判断。
场景五:师范生与新手教师的“数字微格”训练
微格教学是教师教育的经典环节,但传统上依赖指导教师的实时点评。引入模型后,师范生的试讲视频可获得即时、多维、可回放的分析:提问层次、候答时间、反馈质量、板书结构一目了然。研究表明式的训练闭环——“练习—即时证据反馈—再练习”——能显著缩短新手从“会讲”到“会教”的距离;CLASS各维度的行为锚点也为训练目标提供了国际通用的参照系[17]。
推进策略:学校落地的“三步走”
● 第一步·试点期(约一学期):选择1—2个学科、以自愿为原则组建试点教研组;坚持“双轨评价”——AI报告仅供研讨参考,不作任何考核用途;同步采集“人机一致性”基线数据。
● 第二步·扩面期(约一学年):结合学科实际本地化修订指标与量规;将AI报告嵌入LICC三阶段教研流程;开展人机一致性抽检与教师使用反馈调查,形成校级《模型使用与效度简报》。
● 第三步·常态期(一年以后):发布年度效度论证报告;建设校本优秀课例证据库;参与区域案例共享与模型迭代,逐步从“项目试点”转为“制度安排”。
为便于行动,给出一份简明的学校清单:
● □ 成立由分管校长牵头的课堂评价改革小组,成员含教研组长、信息技术教师与骨干班主任;
● □ 对照“白名单”制度完成工具与平台的安全审核,签署数据协议与知情同意;
● □ 选取一个学科、一组观察点先行开发“指标—课标”映射表,并经两轮专家审议;
● □ 每月开展一次“证据式教研”,要求每个观点挂接至少一条证据片段;
● □ 每学期完成一次人机一致性抽检(不低于20%课例)与教师问卷;
● □ 每学年形成一份效度论证简报,决定模型是否扩面、修订或暂停。
五、挑战与展望:在热情与清醒之间
(一)技术之限:幻觉与黑箱
大模型的幻觉问题在评价场景会被专业语境放大:一段对话被误判为“深度互动”、一个沉默被解读为“思维游离”,都可能失之毫厘、谬以千里。模型的对策是制度化的——双模型交叉验证、证据强制引用、低置信度转人工;但更根本的清醒剂是:现阶段AI评价结论只能作为证据线索,不能作为最终结论。包括模型厂商在内的各方使用建议也持同样审慎的立场:AI适合先承担起草、汇总与线索发现,专业判断始终在人。
(二)评价之限:可见行为不等于不可见思维
课堂观察捕获的是外显行为,而核心素养中的思维过程、审美体验与价值观念,大量发生在“沉默的瞬间”。崔允漷在专访中明确提示了课堂观察的固有局限[8]——AI把可见部分看得更清楚,恰恰提醒我们不可见部分更需要人的专业判断。要警惕“指标好即课堂好”的还原论陷阱:一节课的教育价值,永远大于一组指标之和。
(三)伦理之限:隐私、公平与“数据化育人”的风险
课堂音视频是未成年人最敏感的数据类型之一,采集、存储、使用的每一步都必须经得起“家长之问”。算法公平同样不容乐观:方言口音可能拉低语音识别精度,城乡校舍与设备条件可能造成系统性的证据质量差异,模型训练数据中的偏差可能转化为对特定群体的误判。TALIS 2024显示,约七成教师担心AI使学生更易抄袭作弊,约四成教师担心AI放大偏见、强化错误概念或危及数据安全[9]——教师的集体担忧不是阻力,而是伦理制度设计最重要的“用户需求”。此外,当课堂中的人被持续数据化,还需警惕监控文化对师生教与学行为的扭曲:评价的首要伦理,是评价本身不伤害教与学。
(四)教师之变:从“被评价者”到“评价主导者”
TALIS 2024揭示的最大短板不在工具而在人:约四分之三尚未使用AI的教师自认缺乏使用AI教学所需的知识与技能;而新加坡教师AI使用率高达75%的背后,是76%的教师接受过AI教学应用的职业培训(OECD平均仅38%)[9][10]。这组对照说明:教师数字素养投入是AI课堂评价成败的分水岭。模型的使用者不是被技术替代的旁观者,而是握有“解释权与判断权”的主导者——AI供给证据,教师作出教育判断与价值选择,这是本模型一切设计的前提。
(五)展望:走向“备—教—学—评”一体化的智能体生态
可以预期,教育大模型将沿着“多模态—长推理—智能体(Agent)”的方向演进:评价不再是孤立环节,而是与备课、教学、练习贯通的一体化智能体生态——课前AI协助设计目标与任务,课中实时提供过程证据,课后自动生成个性化改进建议并跟踪落实。2025年世界数字教育大会发布的《中国智慧教育白皮书》描绘了迈向智慧教育的愿景图景。但无论技术如何演进,一个判断不会改变:评价的教育性永远先于技术性。技术再强大,也只能回答“证据是什么”;“证据意味着什么、教育向何处去”,必须由教师、学校与时代共同回答。
结语:从纸笔测验到多模态课堂评价,从经验直觉到证据推理,课堂评价正在经历一场静水深流的范式转换。AI大模型不是课堂的裁判,而是专业判断的放大器。让证据说话,让教师判断,让学生被看见——这是本模型的全部旨归。
参考文献
[1] 中华人民共和国教育部. 义务教育课程方案(2022年版)[S]. 北京:北京师范大学出版社,2022.
[2] 中华人民共和国教育部. 义务教育课程标准(2022年版)[S]. 北京:北京师范大学出版社,2022.
[3] 中共中央,国务院. 教育强国建设规划纲要(2024—2035年)[Z]. 2025-01.
[4] 教育部基础教育教学指导委员会. 中小学人工智能通识教育指南(2025年版)[Z]. 2025-05.
[5] 教育部基础教育教学指导委员会. 中小学生成式人工智能使用指南(2025年版)[Z]. 2025-05.
[6] 教育部办公厅. 关于组织实施数字化赋能教师发展行动的通知(教师厅函〔2025〕13号)[Z]. 2025.
[7] 沈毅,崔允漷. 课堂观察:走向专业的听评课[M]. 上海:华东师范大学出版社,2008.
[8] 刘帅,崔允漷. 走向专业实践的课堂观察——专访华东师范大学崔允漷教授[J]. 基础教育课程,2024(10):16-19.
[9] OECD. Results from TALIS 2024: Teaching for Today's World[R]. Paris: OECD Publishing, 2025.